L'edge AI consiste à exécuter un modèle d'intelligence artificielle directement sur l'appareil qui produit les données (caméra, capteur, robot, téléphone, machine), au lieu d'envoyer ces données à un serveur dans le cloud. Vous y gagnez la latence, le fonctionnement hors connexion et la confidentialité ; vous y perdez la puissance de calcul et la facilité de mise à jour. Et non, ça n'a rien à voir avec le navigateur Microsoft Edge, même si Google mélange les deux dans ses suggestions.
La décision se prend sur cinq critères : définition, fonctionnement, matériel pour un premier prototype, puis la grille pour trancher cloud ou appareil produit par produit.
Edge AI : définition et périmètre
📍 Le principe en une phrase. Le modèle tourne là où la donnée naît, et la réponse revient en millisecondes, avec ou sans réseau.
L'inférence quitte le cloud
Red Hat définit l'edge AI comme l'usage de l'IA combiné à l'edge computing pour traiter la donnée à l'endroit où elle est collectée, ou à proximité. L'exemple classique : une reconnaissance d'image exécutée sur la caméra, sans aller-retour vers un datacenter. IBM ajoute que les entreprises y viennent pour réduire la latence, renforcer la sécurité et diminuer les coûts.
Ce qui reste dans le cloud, c'est l'entraînement. Red Hat le dit sans détour : l'edge AI « ne pourrait pas exister sans le cloud computing », parce que les appareils en périphérie n'ont ni la puissance ni le volume de données pour entraîner un modèle profond. Le cloud entraîne, compresse, déploie, surveille ; l'appareil exécute.
Edge AI, edge computing, IA embarquée : trois termes, un principe
Edge computing désigne le calcul rapproché de la source, IA ou non. Edge AI est le cas particulier où ce calcul est un modèle d'IA. IA embarquée (« embedded AI ») insiste sur le matériel : le modèle vit dans un objet, souvent un microcontrôleur ou une carte dédiée. Microsoft Edge est un navigateur, et « IA Microsoft Edge » désigne Copilot dedans ; rien à voir.
Comment fonctionne l'edge AI
⚙️ Deux temps. On entraîne au centre, on exécute au bord. Entre les deux, on compresse.
Entraîner au centre, exécuter au bord
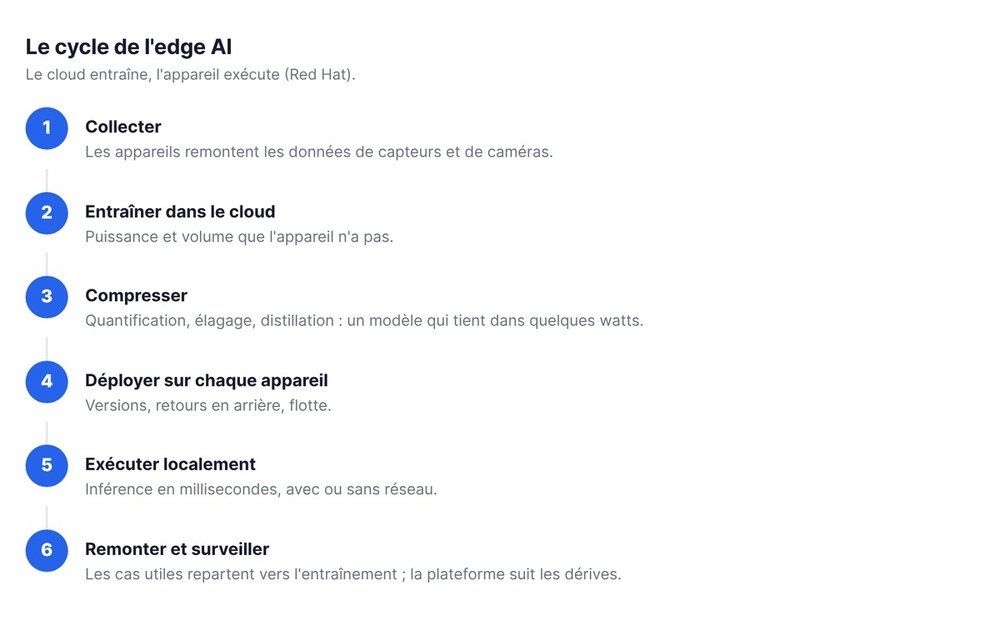
Le cycle décrit par Red Hat tient en quatre étapes. Entraînement dans le cloud, sur les données remontées des appareils. Déploiement d'une version optimisée du modèle sur des appareils aux ressources limitées. Synchronisation : l'appareil traite localement et remonte ce qui sert à réentraîner. Surveillance : la plateforme cloud suit la flotte, détecte les dérives, prépare la maintenance.
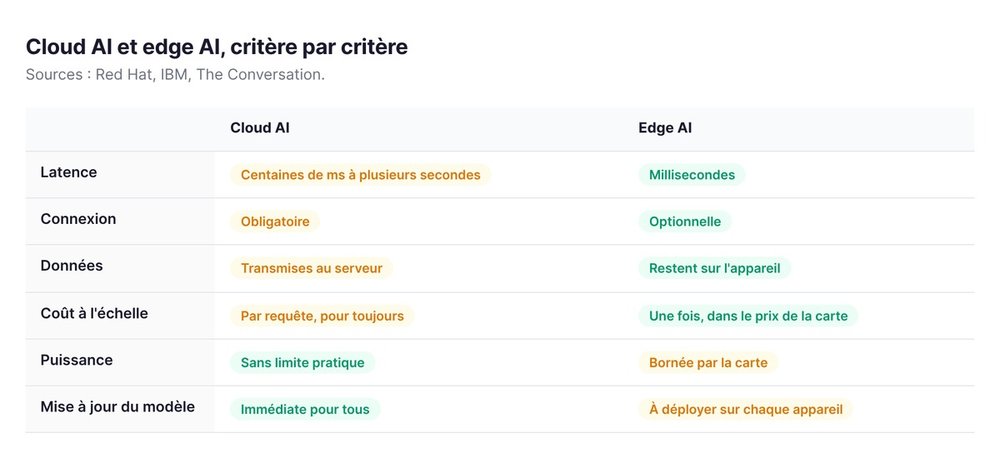
Un article de The Conversation donne l'ordre de grandeur qui justifie tout ça : envoyer de gros volumes de données IoT vers le cloud ajoute « de quelques centaines de millisecondes à plusieurs secondes » de délai selon le réseau et le volume. Pour un compteur intelligent, c'est tolérable. Pour un robot qui évite une personne, non.
Compresser un modèle : quantification, distillation, élagage
Trois techniques réduisent un modèle trop lourd pour une carte à quelques watts. La quantification remplace les nombres à virgule flottante par des entiers plus courts. L'élagage (« pruning ») supprime les connexions qui ne servent à rien. La distillation entraîne un petit modèle à imiter un grand. Red Hat cite les deux premières parmi les outils fournis par les services cloud pour préparer un modèle à l'edge. Les runtimes comme LiteRT de Google (l'ancien TensorFlow Lite) ou ONNX Runtime exécutent ensuite ce modèle compressé sur le processeur, le GPU ou l'accélérateur de la carte.
Avantages et limites de l'edge AI
⚖️ Quatre gains, trois coûts. Les glossaires de fournisseurs listent les gains. Voici aussi les coûts.
Latence, hors connexion, confidentialité, coût à l'échelle
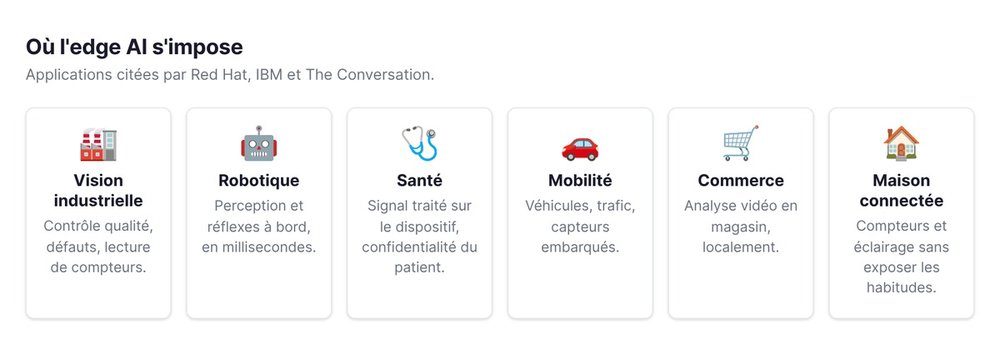
Red Hat retient cinq avantages : consommation d'énergie réduite, bande passante réduite, confidentialité (la donnée sensible ne quitte pas l'appareil), sécurité (on ne transmet que l'essentiel), évolutivité. The Conversation insiste sur la confidentialité avec un exemple parlant : dans une maison connectée, les données d'un compteur ou d'un éclairage révèlent les habitudes d'occupation ; les traiter localement évite de les exposer.
Une inférence cloud coûte à chaque requête, pour toujours. Une inférence sur l'appareil coûte une fois, dans le prix de la carte. À dix appareils, le cloud gagne. À dix mille, le calcul s'inverse.
Puissance limitée, mise à jour, sécurité physique
La puissance : une carte à 25 watts n'exécute pas le même modèle qu'un serveur, et Lenovo, dans son propre glossaire, liste les « limites de l'Edge AI Computing » à côté de ses points forts. La mise à jour : un modèle corrigé dans le cloud est corrigé pour tous ; sur dix mille appareils, il faut un mécanisme de déploiement, des versions, des retours en arrière. La sécurité physique : l'appareil est chez le client, exposé au vol, au démontage, à l'extraction du modèle.
Applications concrètes
🏭 Quatre terrains où la milliseconde et la donnée sensible décident.
Vision industrielle et robotique
Le contrôle qualité sur ligne, la détection de défauts, la lecture de compteurs, la navigation d'un robot mobile : autant de tâches où l'image ne peut pas attendre un serveur. Ultralytics documente le déploiement de modèles de vision sur NVIDIA Jetson, la carte la plus répandue pour ce cas. Dans un robot, l'edge AI est la couche de perception et de réflexe ; la planification lourde peut rester ailleurs.
Santé, mobilité, commerce
IBM cite les smartphones, les mises à jour de trafic dans les véhicules autonomes et les appareils connectés. Dans la santé, l'edge AI traite l'image ou le signal sur le dispositif pour préserver la confidentialité du patient et raccourcir le délai d'intervention. Dans le commerce, l'analyse vidéo en magasin tourne localement pour la même raison.
Des LLM sur l'appareil ?
Oui, en version réduite. LiteRT annonce la prise en charge de la génération sur appareil, et un fil Reddit francophone compare les « meilleurs modèles LLM en périphérie » fin 2025. Un modèle de langage compact sur un téléphone ou une carte Jetson répond à des commandes simples hors connexion. Pour un raisonnement long, le cloud reste la règle.
Le matériel et les outils pour démarrer
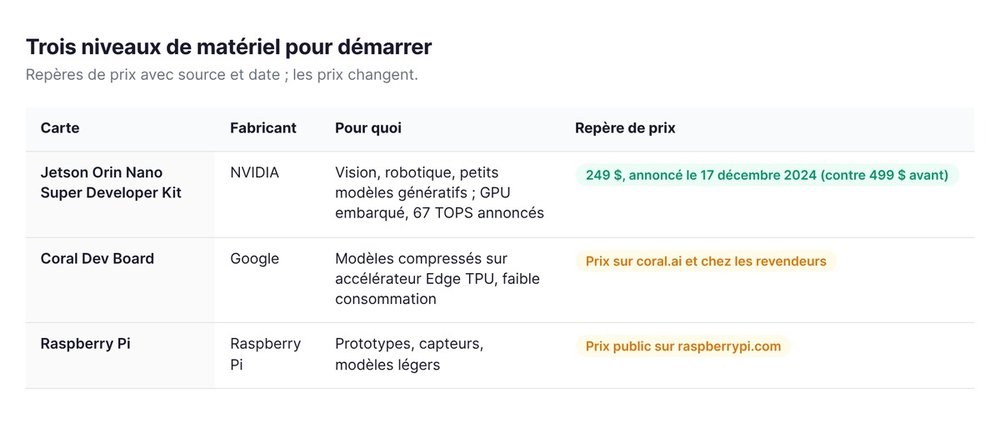
🔌 Trois niveaux de carte, trois outils, un budget de prototype.
Jetson, Coral, Raspberry Pi : trois niveaux
| Carte | Fabricant | Pour quoi | Repère de prix |
|---|---|---|---|
| Jetson Orin Nano Super Developer Kit | NVIDIA | vision, robotique, petits modèles génératifs ; GPU embarqué, 67 TOPS annoncés | 249 dollars, prix annoncé par NVIDIA le 17 décembre 2024 (contre 499 dollars auparavant) |
| Coral Dev Board | inférence de modèles compressés sur accélérateur Edge TPU, faible consommation | prix sur coral.ai et chez les revendeurs | |
| Raspberry Pi | Raspberry Pi | prototypes, capteurs, modèles légers sur CPU ou module d'accélération | prix public sur raspberrypi.com |
Le Jetson Orin Nano est devenu le point d'entrée par défaut pour la vision et la robotique depuis la baisse de prix de décembre 2024, annoncée par NVIDIA sur son blog développeur avec une performance multipliée par 1,7 sur l'inférence générative. Coral et Raspberry Pi restent pertinents pour des modèles plus petits et des budgets d'énergie plus serrés.
Edge Impulse, LiteRT, ONNX Runtime
Edge Impulse est une plateforme de bout en bout pour collecter des données de capteurs, entraîner, compresser et déployer sur l'écosystème de cartes ; Qualcomm a annoncé son acquisition en mars 2025. LiteRT est le runtime de Google, successeur de TensorFlow Lite, déployé selon Google sur des milliards d'appareils. ONNX Runtime est le runtime ouvert qui exécute un modèle exporté au format ONNX depuis PyTorch ou un autre framework. Choisissez une carte, puis le runtime que sa documentation recommande.
Le coût d'un premier prototype
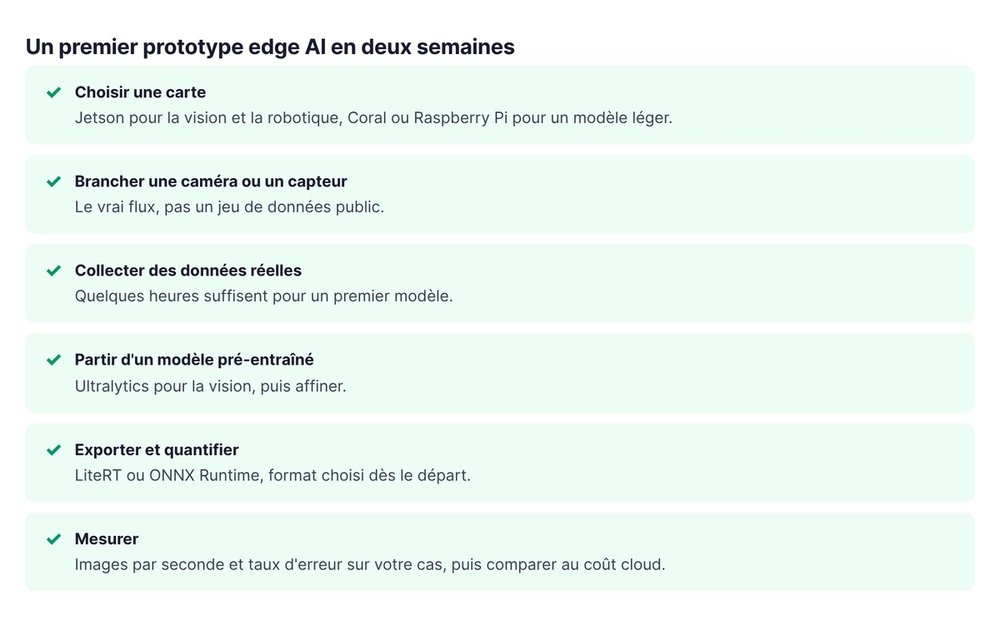
Une carte Jetson à 249 dollars, une caméra, un modèle de vision pré-entraîné (Ultralytics en fournit) et une semaine d'ingénieur pour la chaîne collecte, entraînement, export, déploiement. Le premier résultat mesurable, images par seconde et taux d'erreur sur votre cas, arrive avant la fin de la deuxième semaine.
Quand un founder doit choisir l'edge AI
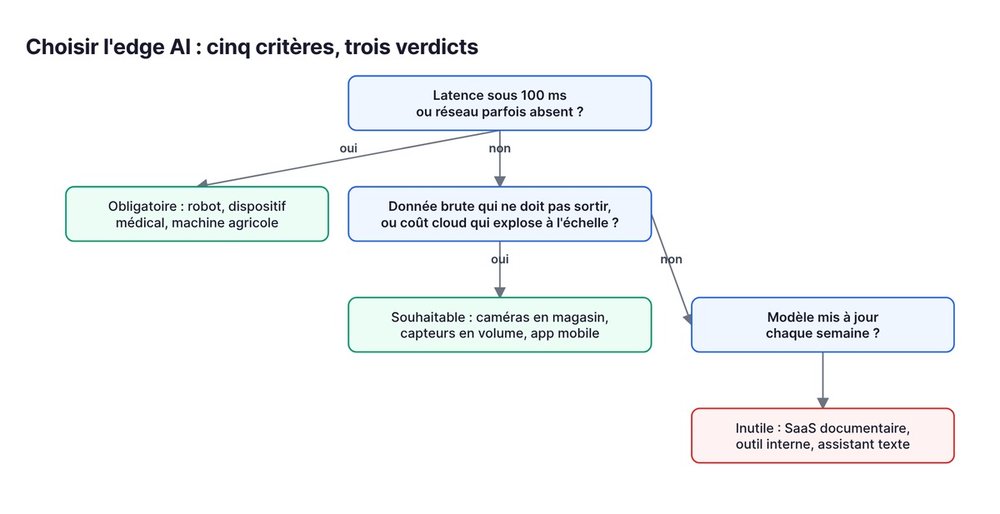
🧮 Cinq critères, trois verdicts. La grille que les glossaires de fournisseurs ne donnent pas, parce qu'ils vendent la carte.
Cinq critères de décision
- Latence. La réponse doit-elle arriver en moins de 100 millisecondes ? Un robot, un véhicule, une machine-outil : oui. Un tableau de bord : non.
- Connectivité. L'appareil sera-t-il parfois sans réseau ? Un champ, un sous-sol, un site industriel, un cabinet médical : souvent.
- Confidentialité. La donnée brute peut-elle sortir du site ? Images de patients, intérieur d'un domicile, ligne de production d'un client : souvent non.
- Coût unitaire à l'échelle. Combien d'appareils, combien d'inférences par jour, pendant combien d'années ? Multipliez, comparez au prix d'une carte.
- Mise à jour du modèle. À quelle fréquence votre modèle change-t-il ? Chaque semaine : le cloud est plus simple. Chaque trimestre : l'edge tient.
Obligatoire, souhaitable, inutile : trois verdicts par produit
- Obligatoire quand le critère 1 ou 2 est vrai. Robot mobile, dispositif médical au lit du patient, machine agricole, caméra de sécurité autonome.
- Souhaitable quand le critère 3 ou 4 domine. Analyse vidéo en magasin, capteurs industriels en volume, application mobile qui traite l'image de l'utilisateur.
- Inutile quand aucun des cinq ne s'applique. Un SaaS B2B qui traite des documents, un outil interne, un assistant textuel : le cloud gagne, et l'edge ajoute une complication.
Quand le verdict est « souhaitable », la décision la moins risquée est de commencer en cloud avec une architecture qui permet de migrer l'inférence plus tard : le modèle exporté au format ONNX ou LiteRT dès le départ, l'appareil qui remonte ses données, le coût par inférence mesuré. Le reste du hub Tech couvre les autres couches, et si vous construisez un produit hardware, vous pouvez candidater à swanbase.
La couche calcul embarqué de la Physical AI
Dans le pilier swanbase sur la Physical AI, la stack d'un système qui agit dans le monde physique commence par « capteurs et calcul embarqué ». L'edge AI est cette couche. Elle exécute la perception et les réflexes sur la machine, pendant que les world models et la planification lourde peuvent vivre ailleurs. Les robots humanoïdes français en sont l'illustration : Calvin perçoit et s'équilibre à bord, en millisecondes.
FAQ sur l'edge AI
Quelle différence entre edge AI et edge computing ?
L'edge computing rapproche le calcul de la source des données, quel que soit le calcul. L'edge AI est le cas où ce calcul est l'inférence d'un modèle d'IA. Tout edge AI est de l'edge computing ; l'inverse est faux.
L'edge AI remplace-t-elle le cloud ?
Non. Le cloud entraîne les modèles, les compresse, les déploie et surveille les appareils. L'edge exécute. Red Hat résume : l'edge AI ne pourrait pas exister sans le cloud.
Faut-il un GPU pour faire de l'edge AI ?
Pas toujours. Un microcontrôleur exécute un modèle de détection d'anomalie sur un capteur ; un accélérateur comme le Coral Edge TPU suffit pour de la classification d'images ; un GPU embarqué comme le Jetson devient utile pour la vision en haute résolution, la robotique et les petits modèles génératifs.