Un world model est un modèle d'IA qui apprend à prédire comment le monde évolue, à partir d'observations (vidéo, capteurs, actions), là où un LLM apprend à prédire le mot suivant dans un texte. Yann LeCun, prix Turing 2018 et ancien directeur scientifique de Meta, a quitté Meta fin 2025 pour fonder AMI Labs à Paris et construire ces world models, parce qu'il juge que la prédiction de texte, même à très grande échelle, ne produira jamais une machine qui comprend les conséquences d'une action.
Pour un founder, la question utile tient en une ligne : qu'est-ce que ça permet de construire maintenant, avec quels modèles, et à quel prix d'entrée. L'issue du débat entre chercheurs attendra.
Un world model, c'est quoi ?
🧭 Définition. Un world model (modèle du monde) est une représentation interne de l'environnement qu'un système d'IA utilise pour anticiper l'effet de ses actions avant de les exécuter. Wikipédia en français le décrit par analogie avec le modèle mental d'un humain : une carte de la dynamique du monde, pas une copie du monde.
Prédire le monde au lieu de prédire le mot suivant
Un LLM a lu des milliards de phrases qui décrivent la gravité. Il sait écrire qu'un verre lâché tombe. Un world model a regardé des heures de vidéo où des objets tombent, et il a appris à prédire la trajectoire. Le premier décrit, le second anticipe.
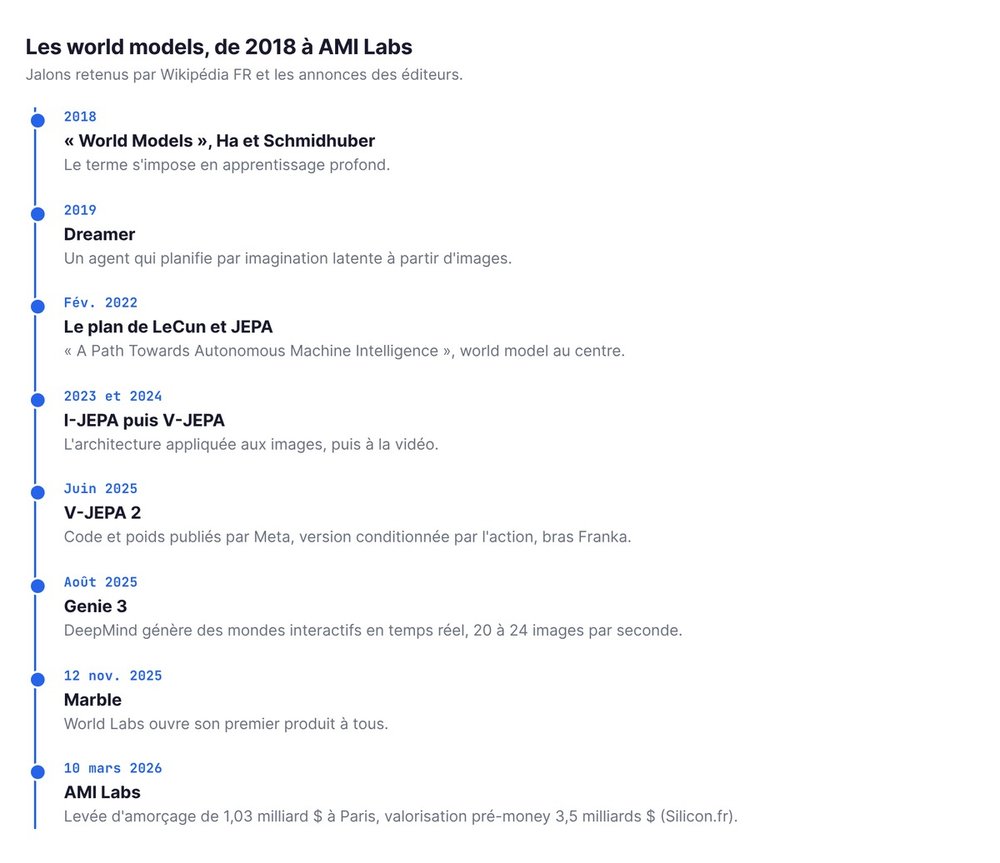
Le terme s'est imposé en apprentissage profond avec l'article « World Models » de David Ha et Jürgen Schmidhuber en 2018, mais l'idée vient de l'apprentissage par renforcement des années 1980 : un agent qui possède un modèle de son environnement peut simuler plusieurs futurs, comparer, puis agir. Les modèles vidéo prédictifs comme Dreamer (2019) et les architectures JEPA de Meta (2022) sont les jalons récents que Wikipédia retient.
La carte mentale du joueur d'échecs, l'image de LeCun
Un joueur d'échecs ne simule pas chaque photon de l'échiquier. Il tient une carte abstraite de la position et anticipe trois coups. C'est l'image que LeCun emploie pour son approche : un world model utile n'a pas besoin de reproduire le monde en pixels, il doit en saisir la logique et prédire dans un espace de représentation abstrait.
Cette distinction, abstraction contre simulation réaliste, sépare les équipes qui construisent des world models.
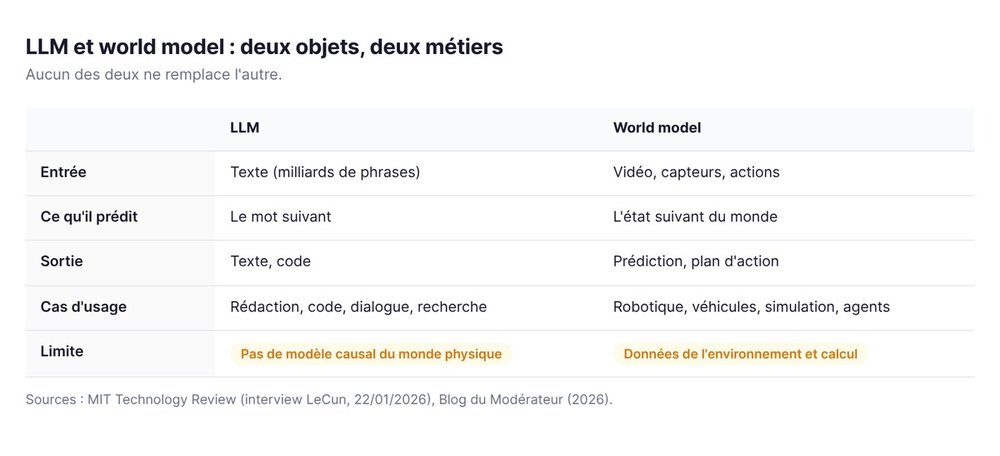
World model vs LLM : la différence utile
⚖️ Deux objets, deux métiers. Le LLM manipule le langage. Le world model manipule des états du monde et leur évolution. Aucun des deux ne remplace l'autre.
Un LLM et la gravité
Dans son interview à la MIT Technology Review de janvier 2026, LeCun résume sa critique : les LLM « manipulent très bien le langage », mais l'idée qu'il suffit de les faire grossir pour atteindre une intelligence de niveau humain est « simplement fausse ». La partie difficile, dit-il, c'est comprendre le monde réel. Il cite le paradoxe de Moravec, formulé en 1988 : ce qui est facile pour nous (percevoir, se déplacer) est dur pour les machines, et inversement.
Un LLM sait que le verre tombe ; il ignore ce qui se passe si le verre est posé au bord d'une table qui vibre, parce qu'aucun texte ne décrit cette scène. Le world model, entraîné sur la scène et ses variantes, produit une prédiction.
Deux usages, sans remplacement
Les LLM répondent à des besoins universels : résumer, rédiger, dialoguer, coder. Les world models sont faits pour anticiper et agir : robotique, véhicules autonomes, simulation, agents qui prennent des décisions dans un environnement. Le Blog du Modérateur, dans son dossier de 2026, cite la Head of Data Science du groupe Hellowork : les world models seront « cachés », comme l'IA d'avant ChatGPT, et feront tourner des outils plutôt que des interfaces grand public.
LeCun lui-même le dit à la MIT Technology Review : les LLM deviendront « l'orchestrateur » de systèmes où le modèle du monde fait le travail de prédiction.
Pourquoi Yann LeCun parie sur les world models
📍 Le contexte en trois faits. Turing Award 2018 avec Hinton et Bengio. Fondateur du laboratoire FAIR de Facebook en 2013, directeur scientifique de Meta jusqu'à son départ annoncé en novembre 2025. Fondateur d'AMI Labs, Advanced Machine Intelligence, siège à Paris.
Le plan de 2022 et JEPA
En février 2022, LeCun publie « A Path Towards Autonomous Machine Intelligence », un texte de position qui décrit une architecture complète d'agent autonome. Au centre : un world model qui prédit l'évolution du monde, y compris les conséquences des actions de l'agent. L'architecture qu'il propose pour l'implémenter s'appelle JEPA, Joint Embedding Predictive Architecture.
JEPA ne prédit pas des pixels. Elle encode deux observations liées (deux images, deux moments d'une vidéo) dans un espace abstrait, puis entraîne un prédicteur à retrouver la représentation de l'une à partir de l'autre. Les détails imprévisibles (texture d'une surface, grain de lumière) sont ignorés ; la structure (formes, trajectoires, relations spatiales) est conservée. C'est l'argument de LeCun contre les modèles génératifs vidéo : « le monde est imprévisible ; si vous essayez de prédire chaque détail du futur, vous échouerez ».
I-JEPA en 2023 applique l'idée aux images, V-JEPA en 2024 à la vidéo. V-JEPA 2, publié par Meta en juin 2025 avec code et poids, ajoute une version conditionnée par l'action, entraînée avec un petit volume de données robot, et Meta montre le modèle piloter un bras Franka sur des tâches de saisie et de dépose dans des environnements nouveaux.
AMI Labs à Paris
AMI Labs a annoncé le 10 mars 2026 une levée d'amorçage de 1,03 milliard de dollars, soit environ 890 millions d'euros, pour une valorisation pré-money de 3,5 milliards de dollars, selon Silicon.fr. Le siège est à Paris, la direction générale revient à Alexandre Lebrun, cofondateur de Nabla, et LeCun garde le rôle scientifique. Les world models sont sortis du laboratoire.
LeCun décrit à la MIT Technology Review des applications qui ne ressemblent pas à un chatbot : un modèle holistique d'un moteur d'avion ou d'une aciérie appris à partir de milliers de capteurs, ou des lunettes qui comprennent ce qu'elles voient. Ses systèmes seront entraînés « sur de la vidéo, de l'audio et des données de capteurs de toutes sortes », de la position d'un bras robotisé au lidar.
Comment on construit un world model
🔧 Le principe. On montre au modèle beaucoup de vidéo ou de situations, on lui demande d'anticiper la suite sans rien annoter à la main, et il apprend les conséquences des actions.
Observer de la vidéo, prédire dans l'espace latent
La recette JEPA en trois blocs : un encodeur transforme l'observation en représentation compacte ; un prédicteur apprend la dynamique dans cet espace, à partir de la représentation courante et de l'action ; un terme de régularisation empêche le modèle de tricher en produisant des représentations vides. LeWorldModel, publié en 2026 par des chercheurs de Mila, NYU et Brown avec LeCun parmi les auteurs, montre qu'un tel modèle peut s'entraîner de bout en bout à partir des pixels avec seulement deux termes de perte, pour un coût de calcul réduit par rapport aux méthodes précédentes.
La prédiction se fait dans un espace abstrait, pas dans l'image : moins coûteux qu'une génération vidéo, moins spectaculaire à regarder.
Les trois écoles : LeCun, Fei-Fei Li, Hassabis
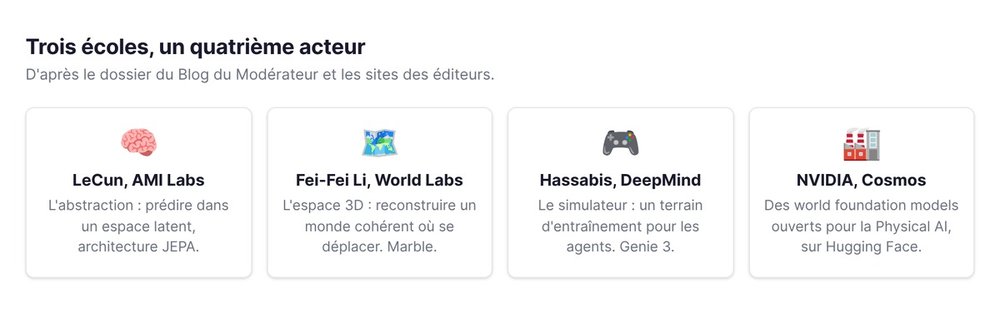
Le dossier du Blog du Modérateur résume trois approches concurrentes :
- Yann LeCun, AMI Labs. L'abstraction. Le world model saisit la logique du monde, pas son apparence. JEPA.
- Fei-Fei Li, World Labs. La perception spatiale. Le world model reconstruit un espace tridimensionnel cohérent dans lequel on se déplace. Marble, leur premier produit, génère des mondes 3D persistants à partir de texte, d'images ou de vidéo, et il est ouvert au public depuis le 12 novembre 2025.
- Demis Hassabis, Google DeepMind. Le terrain d'entraînement. Le world model est un simulateur dans lequel un agent s'exerce. Genie 3, présenté en août 2025, génère des environnements interactifs en temps réel à 20 à 24 images par seconde en 720p ; Google l'ouvre progressivement via Project Genie aux abonnés AI Ultra, d'abord aux États-Unis.
NVIDIA occupe une quatrième place avec Cosmos, une famille de « world foundation models » pour la Physical AI, téléchargeable sur Hugging Face, pensée comme simulateur physique et comme base de post-entraînement pour des robots.
Les world models accessibles aujourd'hui
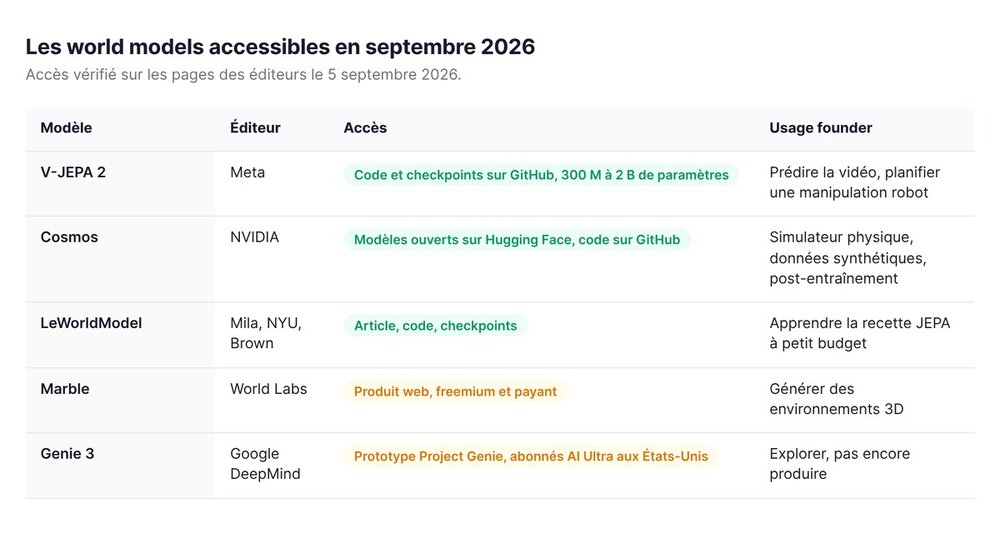
🗂️ Quatre points d'entrée. Deux sont ouverts avec code et poids, un est un produit grand public, un est un prototype de recherche sur abonnement.
V-JEPA 2, Cosmos, Genie, LeWorldModel : qui donne accès à quoi
| Modèle | Éditeur | Accès | Usage founder |
|---|---|---|---|
| V-JEPA 2 | Meta | code et checkpoints sur GitHub (encodeurs de 300 millions à 2 milliards de paramètres) | comprendre et prédire de la vidéo, planifier une manipulation robot à partir d'un but en image |
| Cosmos | NVIDIA | modèles ouverts sur Hugging Face, code sur GitHub | simulateur physique, données synthétiques, post-entraînement sur vos caméras et votre robot |
| LeWorldModel | Mila, NYU, Brown | code et checkpoints publiés avec l'article | apprendre la recette JEPA de bout en bout à petit budget de calcul |
| Marble | World Labs | produit web, freemium et payant | générer des environnements 3D pour un jeu, une visite, une simulation |
| Genie 3 | Google DeepMind | prototype Project Genie, abonnés AI Ultra aux États-Unis | explorer des mondes interactifs, pas encore une brique de production |
Le coût d'un premier essai
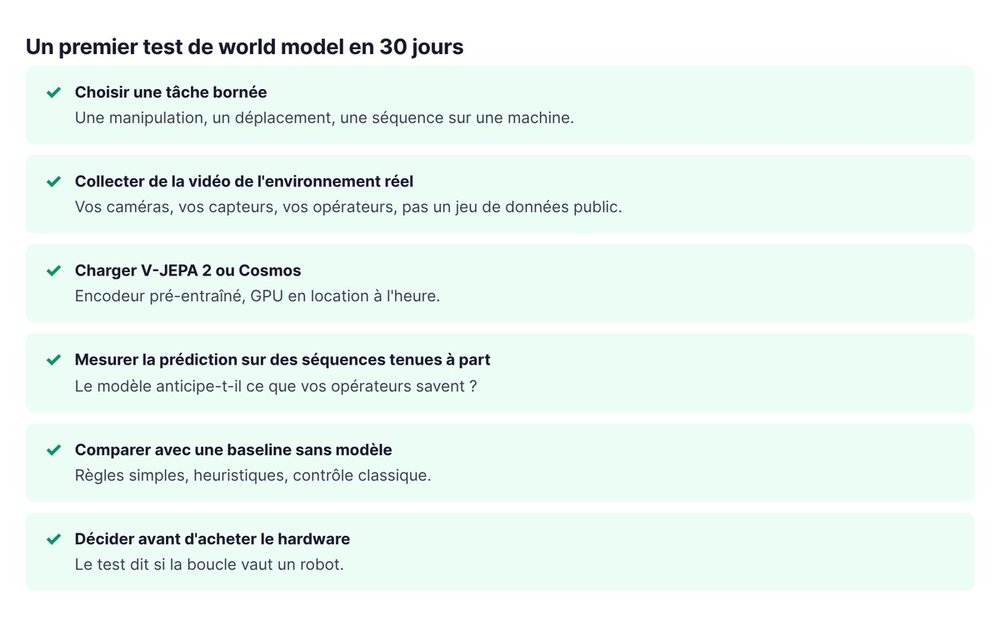
Pour V-JEPA 2 et LeWorldModel, le coût d'entrée est celui d'un GPU de location et d'un ingénieur qui lit un dépôt GitHub. Vous chargez un encodeur pré-entraîné, vous le branchez sur vos vidéos, vous mesurez ce qu'il prédit. Pour Cosmos, l'essai coûte le temps d'apprendre l'outillage NVIDIA. Pour Marble, un abonnement.
Ce qui coûte cher, ce n'est pas le modèle. C'est la donnée de votre environnement : les heures de vidéo de votre entrepôt, de votre bloc opératoire, de votre chaîne. Le pilier swanbase sur la Physical AI et sa stack détaille pourquoi la donnée est le goulot d'étranglement.
Les usages à la portée d'un founder
🏗️ Trois cas où un world model change une décision produit. Et un rappel de ce qu'il ne change pas.
Simuler avant de fabriquer
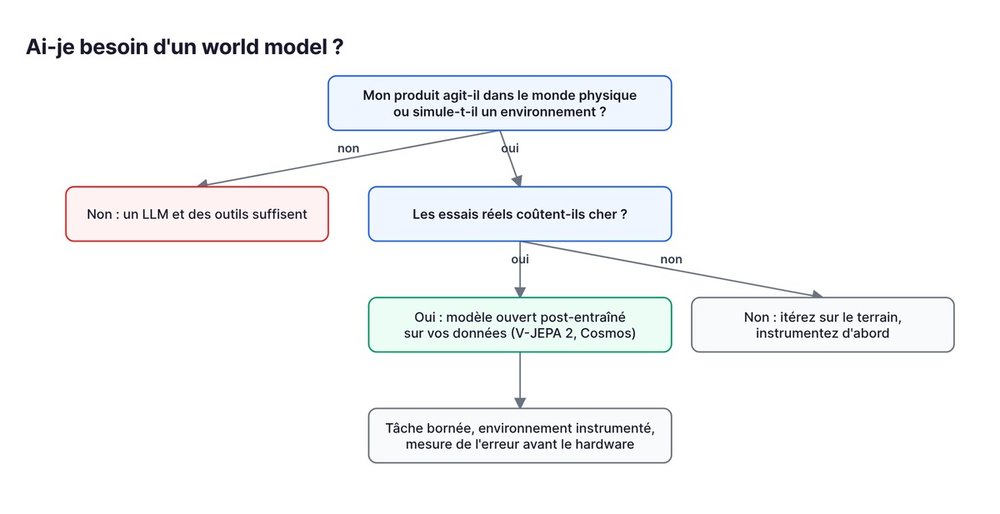
Si votre produit agit dans le monde physique, la question numéro un est le coût des essais réels. Un world model entraîné sur vos vidéos, ou un simulateur comme Cosmos, sert à tester une politique de contrôle des centaines de fois avant de casser une pièce. La démonstration de Meta avec V-JEPA 2 sur un bras Franka, dans un environnement jamais vu, est exactement ce scénario : planifier à partir d'un but en image, sans réapprendre sur place.
Pour un founder, ça se traduit en une décision : commander le hardware plus tard, et prouver la boucle en simulation d'abord.
Des agents capables de planifier
Les agents construits sur un LLM enchaînent des appels d'outils sans savoir ce qui se passe si l'action échoue à moitié. Un agent doté d'un world model peut se poser la question que LeCun cite en exemple, « si je fais ça, que se passe-t-il ensuite ? », et choisir. Le dossier du Blog du Modérateur situe là le basculement : des agents avec « beaucoup plus d'autonomie, beaucoup plus de responsabilités », donc un impact sur toutes les industries qui opèrent des processus.
Le cas industriel décrit par LeCun, un modèle holistique d'une usine à partir de milliers de capteurs, est un produit possible pour une startup verticale qui possède l'accès aux capteurs d'un secteur.
Hors de portée en 2026
Trois choses restent hors de portée d'une équipe de trois personnes : entraîner un world model de fondation (c'est le métier d'AMI Labs, de Meta et de NVIDIA), obtenir une généralisation robuste quand l'environnement change (LeCun lui-même dit qu'« absolument personne » ne sait rendre un robot humanoïde assez intelligent pour être utile), et déployer sans humain dans la boucle sur une tâche où une erreur coûte cher. Le Blog du Modérateur rappelle le point faible : quand un world model décide et agit, l'interface humaine qui relisait les sorties d'un LLM disparaît.
Le bon périmètre en 2026 : une tâche bornée, un environnement instrumenté, un modèle ouvert post-entraîné sur vos données, et une mesure de l'erreur. C'est le conseil du pilier Physical AI, parce que le world model est la couche « construire une représentation et planifier » de cette stack, juste au-dessus du calcul embarqué décrit dans notre article sur l'edge AI, et sous les robots humanoïdes français qui en sont l'application la plus visible.
Si vous construisez sur cette stack, vous pouvez candidater à swanbase.
FAQ sur les world models
Les world models vont-ils remplacer les LLM ?
Non. Les LLM servent au langage et au code ; les world models servent à anticiper et agir. LeCun décrit un futur où le LLM orchestre des systèmes qui incluent perception et modèle du monde. Les deux coexistent, et NVIDIA combine déjà les deux dans Cosmos.
Les world models mènent-ils à l'AGI ?
C'est la thèse de LeCun et de DeepMind, qui présentent leurs world models comme une étape vers une intelligence générale. LeCun précise à la MIT Technology Review que des « percées conceptuelles majeures » restent nécessaires et que ça « ne va pas arriver l'année prochaine ». Sans effet sur ce qu'un founder peut construire aujourd'hui.
Peut-on tester un world model sans GPU ?
Pour explorer, oui : Marble est une application web et Project Genie tourne dans le navigateur pour les abonnés éligibles. Pour post-entraîner V-JEPA 2 ou Cosmos sur vos données, il faut un GPU, en location à l'heure suffit pour un premier essai.